프로젝트 목록으로
개인 프로젝트2025.05 - Present

Playalike (Steam Game Recommend)

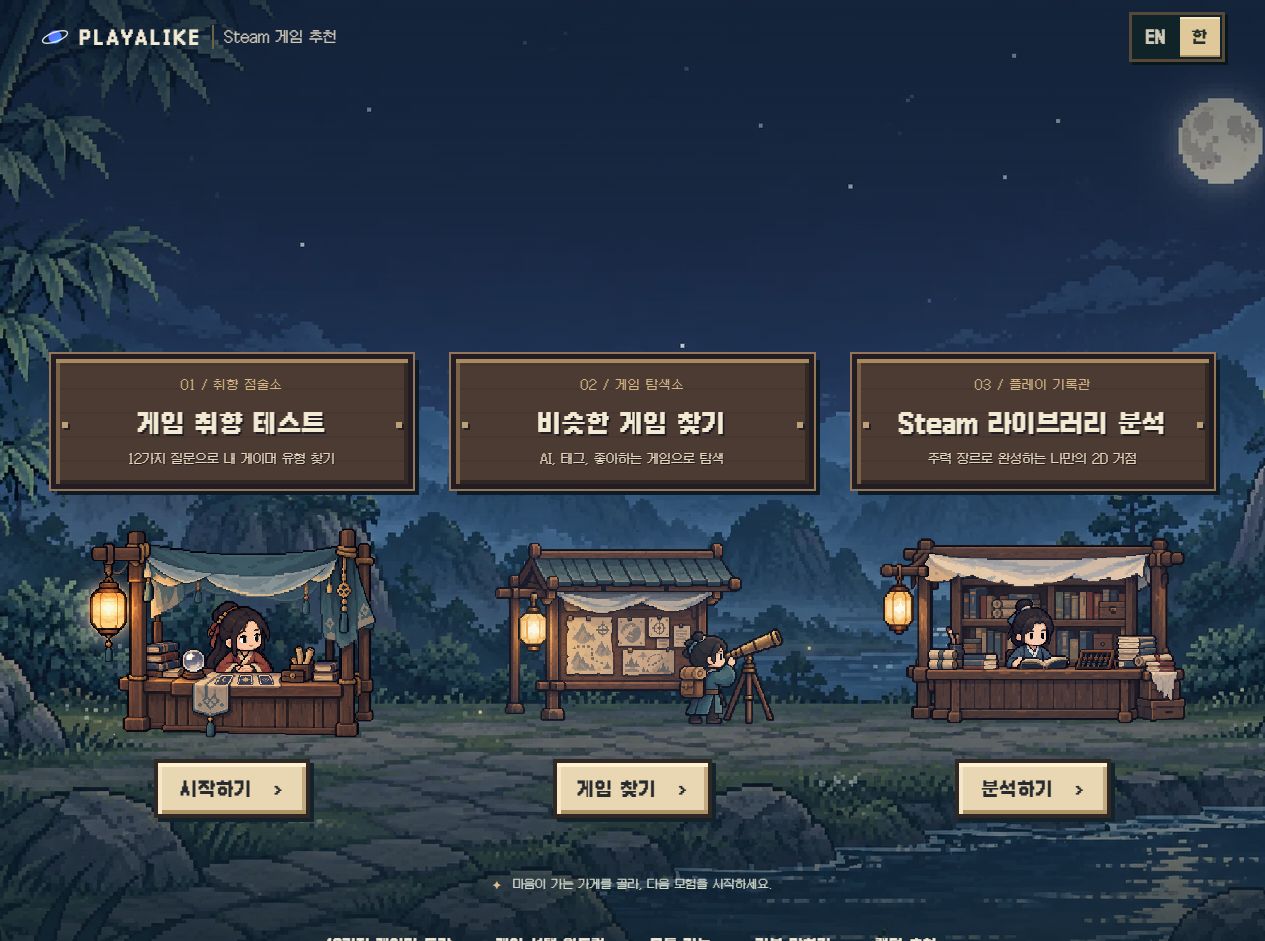
취향 테스트, 비슷한 게임 찾기, Steam 라이브러리 분석으로 게임을 찾아 주는 웹 서비스입니다. 옛 이름은 PLAYLOOM입니다.

내 역할

기획, 데이터 수집, 추천, 백엔드, 프론트엔드, 배포와 운영까지 혼자 맡고 있습니다.

결과

Steam 공식 목록 API로 수집을 바꿔 2025년 6월 이후 출시작 0개를 5,930개로 채웠고, 운영 중인 서비스를 Playalike로 새로 단장했습니다. 백엔드 테스트는 748건(2026-11-02 기록)입니다.

담당 역할

1인 개발 프로젝트로 기획, 데이터 수집, 추천 설계, Spring Boot API, Next.js 프론트엔드, 배포와 운영까지 담당하고 있습니다. 초기에는 태그 동시 출현 기반 추천과 Electron 패키징이 중심이었고, 이후 임베딩 기반 요구사항 매칭, 좋아요와 싫어요를 반영하는 개인화, 추천 근거 표시, 한국어와 영어 지원으로 넓혔습니다. 2026년 11월에는 취향 테스트와 Steam 라이브러리 분석을 더하고 화면 전체를 2D 그래픽으로 새로 만들었습니다. 운영 쪽은 H2에서 PostgreSQL로 옮기고, GitHub Actions에서 테스트를 통과한 이미지만 오라클 클라우드 ARM 서버에 배포하게 했습니다. 게임 목록은 매일 Steam 공식 API로 수집하고, 게임 관계 임베딩은 서버에서 PyTorch 배치로 학습하며, DB는 매일 백업합니다.

Playalike (Steam Game Recommend) screenshot 1

Tech Stack

Spring BootJava 17JPAPostgreSQLpgvectorFlywayNext.jsTypeScriptPyTorchDockerCaddyGitHub ActionsGroqGemini APISteam Web APIResilience4j

아키텍처 / ERD

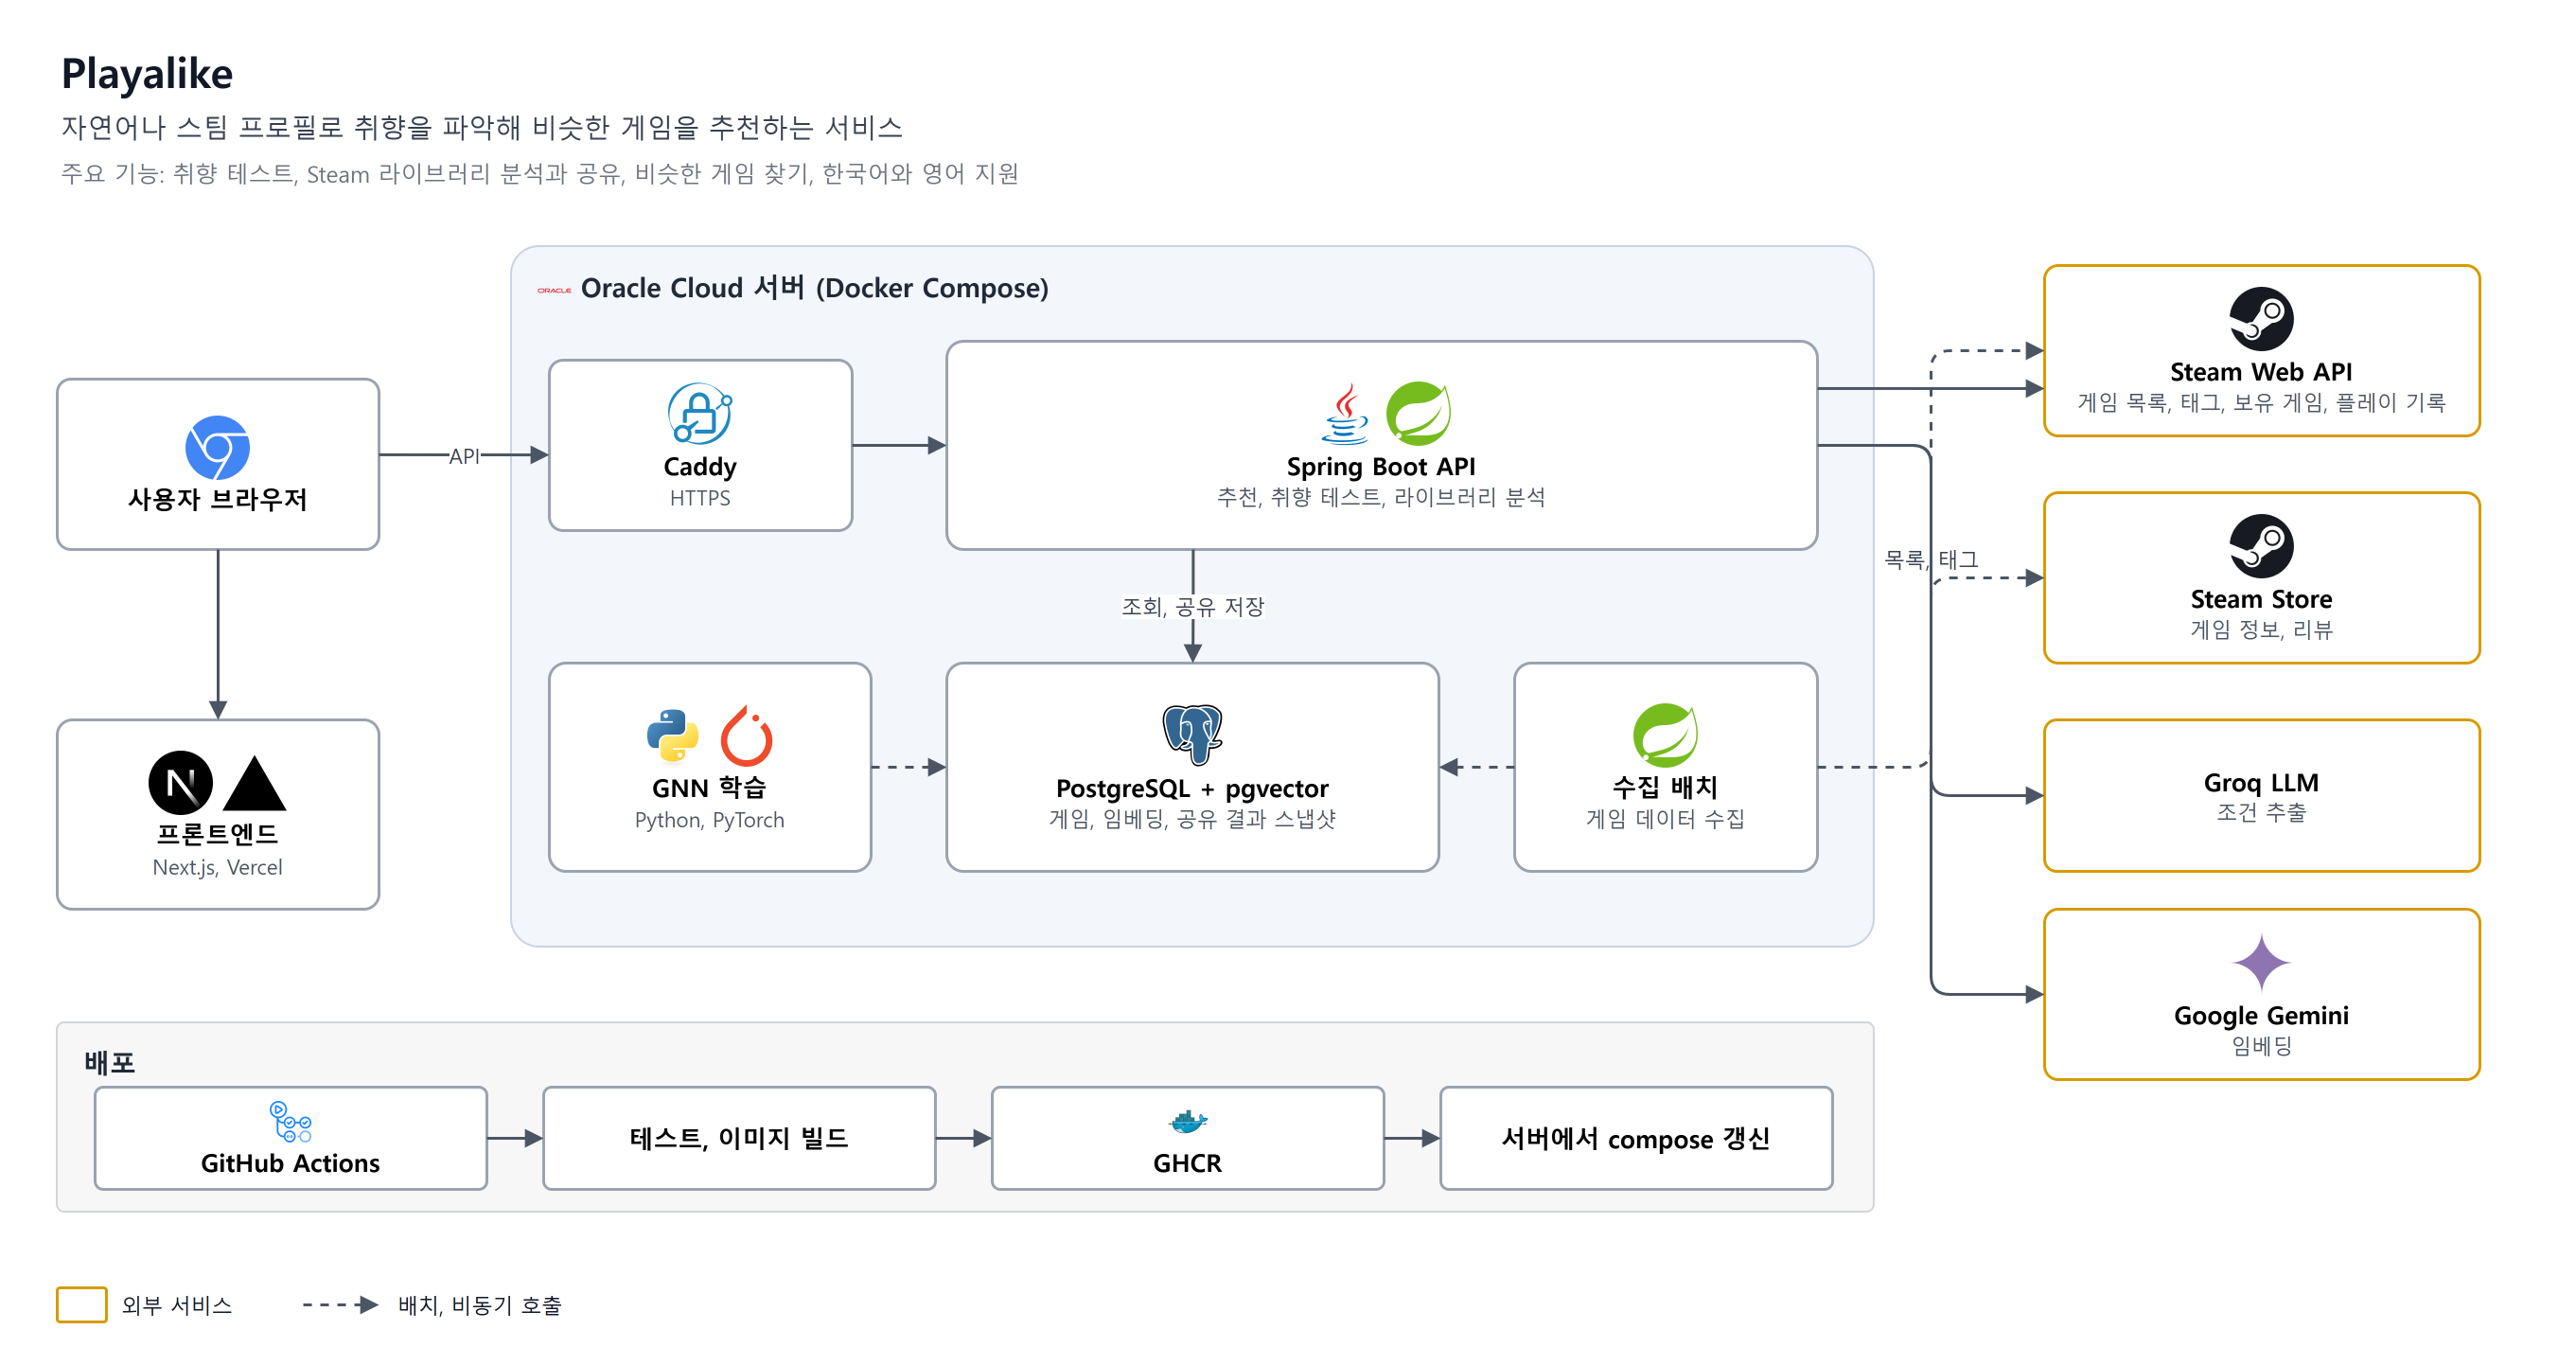
Next.js 프론트엔드가 Spring Boot API를 호출하고, 게임과 태그, 임베딩 벡터, 공유 결과는 PostgreSQL에 저장합니다. 임베딩 검색은 pgvector를 쓰고 스키마 변경은 Flyway로 관리합니다. 게임 목록과 태그는 매일 Steam 공식 목록 API로 수집하고, 수집이 끝나면 태그 쌍 통계를 다시 계산합니다. 게임 관계 임베딩은 서버에서 PyTorch GNN 배치로 학습해 게임 43,796개에 저장했고, 비슷한 게임 찾기에 섞는 기능은 설정으로 켜고 끕니다. 자연어 입력은 LLM이 조건으로 바꾸는 일만 맡고, 추천 이유는 규칙으로 만듭니다. 결과에 붙는 사유와 주의점이 모델이 지어낸 문장이 아니라 실제로 건 조건에서 나오게 하기 위해서입니다.

전체 구조

프론트엔드는 Vercel에서, API와 DB, 수집 배치, GNN 학습은 오라클 클라우드 서버의 Docker Compose에서 돕니다. GitHub Actions가 테스트를 통과한 이미지를 GHCR에 올리면 서버가 compose를 갱신합니다.

Playalike (Steam Game Recommend) 전체 구조

자연어 추천 요청 흐름

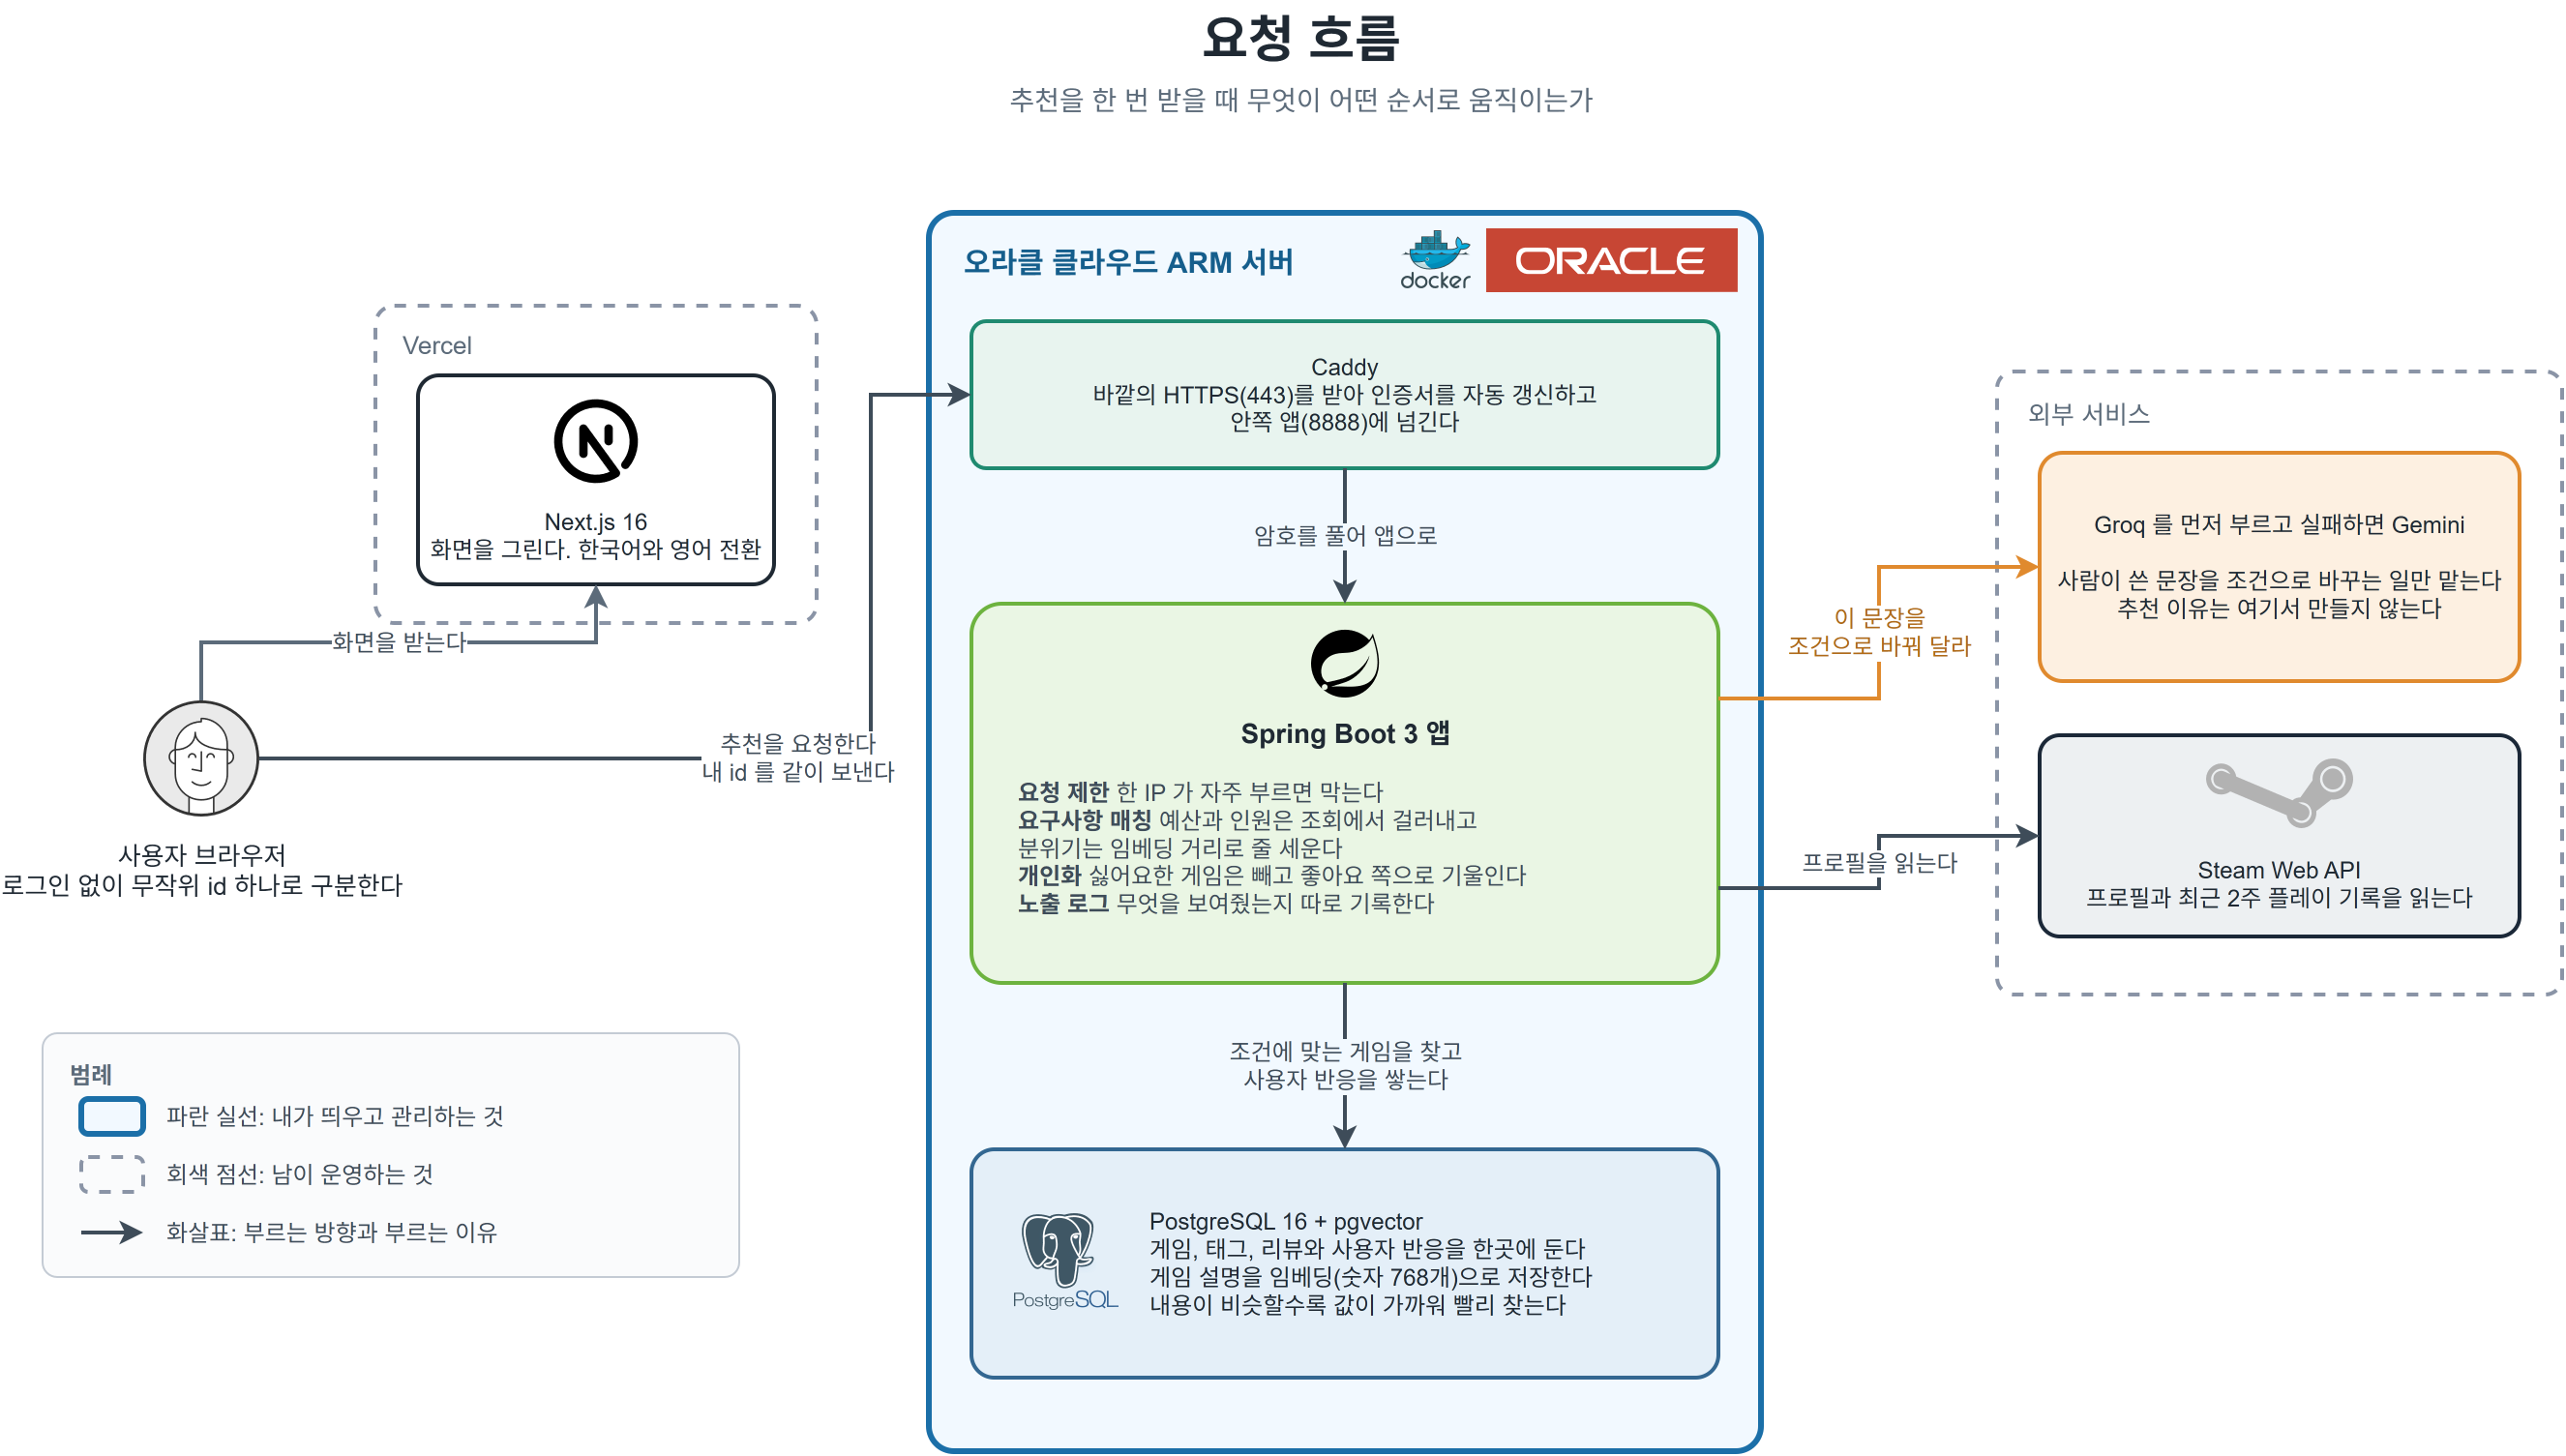
모든 기능 메뉴의 자연어 추천에서 무엇이 움직이는지 보여 줍니다. 추천 이유는 앱이 규칙으로 만들고, 언어 모델은 사람이 쓴 문장을 조건으로 바꾸는 데까지만 씁니다.

Playalike (Steam Game Recommend) 자연어 추천 요청 흐름

문제 해결 과정

매일 정상 종료하던 수집 작업이 신작을 모두 빠뜨린 원인을 찾고, 완료 조건을 바꿨다

  • 2025-06 이후 출시작 0 → 5,930개
  • 카탈로그 30,658 → 41,249개

문제 상황

추천은 DB에 수집된 게임 안에서만 이루어지므로, 목록에서 빠진 신작은 검색이나 추천 결과에 나오지 않는다. Silksong, Borderlands 4처럼 2025년 6월 이후 출시작이 하나도 검색되지 않았는데, 수집 작업은 매일 정상 종료 기록만 남기고 있었다. 처음에는 신작을 넣는 배치를 실행하지 않았다고 생각했지만 실행 기록은 정상이었다. SteamSpy를 직접 호출해 보니 2025-07-18 출시된 마법소녀의 마녀재판의 리뷰 수와 태그가 모두 비어 있었고, 같은 시점 Steam 공식 리뷰 API에는 리뷰가 34,518개 있었다. 출시일별로 비교하니 2025-05-30과 2025-06-10 사이부터 데이터가 갱신되지 않았다. 배치가 리뷰 50개 미만을 걸러 내므로 신작은 오류 없이 모두 탈락했다.

해결 방안

신작만 공식 API로 보충하는 방법은 제외했다. 같은 태그의 가중치가 SteamSpy 7,935, Steam 859처럼 척도가 달라 섞으면 추천 점수가 왜곡되기 때문이다. 대신 Steam 공식 목록 API(IStoreQueryService/Query)로 수집을 모두 옮겨 한 번에 1,000개씩 받게 했다. 수집 완료도 빈 페이지를 받았다는 이유만으로 판정하지 않고, 서버가 알려 준 전체 개수까지 받았는지로 판정하게 바꿨다. 중간에 빈 페이지, 저장 0건, 페이지 전체 저장 실패, 최대 페이지 도달은 모두 실패로 끝나게 했다.

결과

운영 첫 실행(2026-09-29)은 5분 16초에 38,033개를 저장했고 실패는 0이었다. 카탈로그는 30,658개에서 41,249개가 됐고, 2025년 6월 이후 출시작은 0개에서 5,930개가 됐다. 이틀째에는 게임이 하루 만에 2,227개 늘어난 것이 이상해 다시 조사했다. 리뷰 순이라고 믿었던 정렬 옵션 30은 같은 요청에도 순서가 달라 중복 저장과 누락을 만들고 있었다. 전체 131,045개를 한 번씩 순회해 중복이 0개인 정렬 2를 확인하고 바꿨다. 다음 실행에서 저장 횟수 38,842회가 실제 대상 수와 맞았고, 빠졌던 328개 중 327개가 들어왔다.

Steam 라이브러리 분석에서 게임을 많이 모은 사용자가 오히려 실패하던 결함을 리뷰로 막았다

  • 돌연변이 검출 5/6 → 6/6
  • 테스트 478 → 691건

문제 상황

Steam ID로 보유 게임을 읽어 성향을 분석하고, 결과를 90일 동안 링크로 공유하는 기능이다. 공유 링크가 오래 살아 있고 게임을 많이 모은 사용자가 핵심 대상이라, 큰 입력과 Steam 장애, 시간이 지난 저장 데이터를 어떻게 다루는지가 결과를 좌우했다. 리뷰에서 세 가지를 찾았다. Spring WebClient의 기본 응답 버퍼가 256KB라 보유 게임이 약 800개를 넘으면 응답을 읽지 못했고, 그 실패가 Steam 장애(503)로 안내됐다. Steam이 장애 중에 빈 응답을 200으로 주면 프로필 없음이나 비공개로 분류돼 사용자가 멀쩡한 설정을 바꾸게 될 수 있었다. 공유 결과는 코드의 필드 이름을 그대로 저장해서, 이름을 바꾸면 예전 링크의 숫자가 오류 없이 0으로 나올 수 있었다.

해결 방안

버퍼를 16MB로 올리고 게임 4,000개(약 1.18MB) 응답 테스트를 더했다. 응답 모양이 이상하면 사용자 오류가 아니라 Steam 장애로 보게 했다. 공유 결과는 저장 형식에 버전을 붙이고 JSON 필드 이름을 고정했으며, 빠진 값은 0으로 채우지 않고 읽기 실패로 처리했다. 처음 구현에서 테스트를 코드보다 나중에 써서, 판정 경계 여섯 곳을 일부러 바꿔 보는 돌연변이 검사를 따로 돌렸다.

결과

버퍼 설정을 빼면 4,000개 응답 테스트가 실패하는 것을 확인했다. 돌연변이 검사에서는 다양성 80 경계를 테스트가 놓치는 것을 찾아 보강했고, 다시 돌려 여섯 곳 모두 테스트가 실패하는 것을 확인했다. 백엔드 테스트는 478건에서 691건이 됐다. 사용자 지표는 아직 없다.

취향 테스트 추천에서 흔한 태그가 점수를 좌우하던 문제를 희소도 보정으로 고쳤다

문제 상황

게이머 유형 테스트(12문항, 16유형)는 유형마다 Steam 태그 가중치를 두고 게임을 추천한다. 가중치를 단순히 더하면 운영 DB 기준(2026-11-01, 태그 481개) Singleplayer 29,181개, Adventure 20,050개처럼 대부분의 게임에 붙은 태그가 점수를 좌우하고, 태그가 많이 붙은 게임이 유리해진다.

해결 방안

점수를 가중치와 희소도(ln(1 + 전체 게임 수 / 그 태그가 붙은 게임 수))를 곱한 값의 합으로 바꿨다. 정보 검색의 IDF와 같은 생각이다. 태그별 게임 수는 기동 시와 매일 한 번 메모리에 올리고, 비어 있으면 보정 없이 원래 가중치로 순위를 매기며 ERROR를 남긴다. 같은 대표 태그가 3개 이상 몰리지 않게 다양성 규칙도 더했다. 마무리 단계에서 독립적으로 돌린 리뷰 넷 중 셋이 같은 결함을 따로 찾았다. 싫어요 기록이 있는 사용자가 제외 목록 없이 요청하면, 억제를 뺀 재시도에 null이 넘어가 404 대신 500이 났다. 서비스를 목으로 둔 컨트롤러 테스트로는 드러나지 않던 결함이었다.

결과

희소도를 빼면 순서가 뒤집히는 것을 실제 PostgreSQL 테스트로 확인했다. 백엔드 테스트는 386건에서 478건이 됐다. 2026-11-01 운영 배포 뒤 기동 로그에서 12문항, 16유형 문구 검증과 게임 44,435개, 태그 477개의 희소도 계산을 확인했다. 사용자 지표는 아직 없다.

한글로 쓰면 조건이 하나도 안 잡히던 문제를, 엉뚱한 곳에 있던 원인까지 따라가 고쳤다

문제 상황

한글로 요구사항을 적으면 자연어 추출 결과가 모든 항목 비어 있는 채로 돌아왔다. 처음에는 모델이 한글에 약한 줄 알았는데, 서버 키로 Groq 를 직접 불러 보니 세 번 다 제대로 답했다. 다음으로 첫 실패가 6시간 캐시에 남아 같은 입력에 계속 되돌아오는 것을 찾아 고쳤지만, 그것도 진짜 원인은 아니었다. 끝까지 따라가 보니 원인은 전역 ObjectMapper 에 등록된 문자열 직렬화기였다. H2 를 쓰던 시절의 깨진 데이터를 출력에서 덮어 고치려고 넣은 코드가, 모든 문자열을 ISO-8859-1 로 한 번 돌리면서 물음표를 등록상표 기호로 바꿔 놓고 있었다. 스프링이 이 ObjectMapper 를 응답을 만들 때도 바깥으로 요청을 보낼 때도 함께 썼기 때문에, 화면에 나가는 한글이 깨지는 동시에 Groq 와 Gemini 로 보내는 한글 프롬프트까지 물음표로 뭉개졌다.

해결 방안

모델을 바꾸는 방법은 직접 호출이 멀쩡했으므로 제외했다. 출력 문자열을 다시 손보는 방법도, 지금 PostgreSQL 에 들어 있는 데이터는 이미 멀쩡한 UTF-8 이라 그 보정 자체가 문제를 만드는 쪽이어서 제외했다. 먼저 LLM 과 임베딩으로 나가는 WebClient 만 깨끗한 인코더로 새로 조립해 요청 쪽 피해를 끊었고, 그다음 전역 직렬화기 등록을 지웠다. 지우기 전에는 응답에 남은 깨짐 흔적을 글자 코드 단위로 확인해 저장된 데이터 자체는 멀쩡하다는 것을 먼저 봤다. 게임 이름을 다듬는 함수에 남아 있던 같은 치환도 지워, 제목에 물음표가 실제로 들어간 게임이 망가지던 것을 함께 고쳤다. 캐시는 모든 항목이 빈 결과면 저장하지 않도록 바꾸고, 같은 코드가 다시 들어오지 않게 설정 파일에 이유를 주석으로 남겼다.

결과

고친 뒤 인기 게임 22개의 이름과 설명을 받아 확인하니 등록상표 기호 하나와 곡선 따옴표 둘이 원문 그대로 남아 있었고 깨진 글자는 없었다. 원래 실패하던 한글 입력은 인원 3명, 예산 2000센트, 제외 태그 Horror 를 세 번 다 뽑아냈고, 공포라는 낱말도 두 번 다 Horror 로 이어졌다. 인코더가 망가져도 한글이 살아남는지는 제공자마다 테스트로 고정했다.

상관없는 게임까지 좋아요한 게임을 근거로 지목하던 설명을, 판정 기준을 바꿔 잡았다

문제 상황

요구사항 매칭 결과에 좋아요한 게임을 근거로 붙이는 설명을 만들었고, 처음에는 후보와 좋아요한 게임의 유사도가 0.5 를 넘으면 그 이름을 붙였다. 배포하고 나서 보니, 코지한 농장 게임에 좋아요를 누른 사람이 FPS 를 찾으면 Quake, Insurgency, Verdun 같은 슈터에도 전부 그 농장 게임 이름이 붙었다. 유사도 그래프로 실제 값을 재 보니 Gemini 임베딩은 값이 좁은 구간에 몰려 있어서, 같은 장르끼리는 0.857 에서 0.918 사이였고 아무 상관없는 장르끼리도 0.5 를 쉽게 넘었다. 사용자에게 근거를 보여주기로 한 이상, 근거가 틀리면 추천이 틀린 것보다 나쁘다고 봤다.

해결 방안

기준값을 올리는 방법은 값이 워낙 좁게 몰려 있어서 어떤 숫자를 골라도 데이터가 바뀌면 다시 흔들리므로 제외했다. 대신 후보가 좋아요한 게임에서 가장 가까운 30개 안에 들 때만 이름을 붙이도록 바꿨다. 이웃을 찾을 때는 pgvector 의 거리 정렬과 개수 제한을 써서 인덱스를 타게 했고, 좋아요한 게임의 벡터는 한 번에 모아 읽어 좋아요가 늘어도 조회 횟수가 같이 늘지 않게 했다. 좋아요가 여럿이면 더 가까운 쪽을 고르고, 순위가 같으면 먼저 본 것을 쓰며, 후보가 자기 자신을 지목하지는 않게 했다.

결과

기준을 유사도 0.5 에서 가장 가까운 30개로 바꿨다. 같은 조건으로 두 번 다시 확인해 보니, FPS 요청에서 슈터에 잘못 붙은 이름이 두 번 다 4개 중 0개였다. 고치기 전이었다면 4개 중 4개가 나왔을 자리다. 코지한 조건에서는 Dinkum, Fae Farm, Stardew Valley 처럼 실제로 가까운 게임만 지목하고 먼 게임에는 아무것도 붙이지 않았다. 30이라는 숫자는 따로 조정하지 않아도 맞았다.

좋아요와 싫어요를 추천에 반영하면서, 흐름마다 구조가 달라 방법을 나눠 적용했다

문제 상황

좋아요와 싫어요를 받아 두기만 하고 추천에는 쓰지 않고 있었다. 기존 추천 5종은 조건에 맞는 게임을 4개 채우면 바로 멈추는 구조라 순서를 다시 매길 여분이 없었고, 요구사항 매칭만 후보 40개에서 4개를 골랐다. 게다가 싫어요한 게임을 빼다 보면 조건이 좁을 때 후보가 바닥나서, 원래는 성공하던 요청이 결과 없음으로 바뀔 수 있었다.

해결 방안

5종을 전부 후보를 넉넉히 뽑는 구조로 다시 짜는 방법은 손댈 범위가 크고 잘 돌아가는 흐름까지 건드려서 제외했다. 싫어요는 5종에 이미 깔려 있던 제외 목록에 서버가 익명 id 로 찾은 값을 합치는 방식으로 넣었다. 이 제외 목록은 앞서 모든 사용자가 공유하던 추천 이력을 요청 단위로 바꾸면서 만들어 둔 통로라, 새로 배관을 놓지 않고 얹을 수 있었다. 억제 때문에 결과가 비었을 때만 억제를 한 번 풀고 다시 시도해, 되던 요청이 실패로 바뀌지 않게 했다. 좋아요는 후보가 넉넉한 요구사항 매칭에만 적용했다. 좋아요한 게임들의 임베딩 평균을 취향으로 삼고, 후보와 가까운 정도를 뽑기 확률로 바꿔 중복 없이 골랐으며, 취향이 없으면 원래대로 고르게 했다. 이 작업 중에 프로필과 최근 플레이 흐름이 제외 목록을 합치지 않아 억제가 실제로는 안 먹던 것도 찾아 고쳤다.

결과

새 id 로 인기 후보를 25번 뽑아 자주 나오던 16개에 싫어요를 누른 뒤, 15번에 걸쳐 60자리를 다시 요청했더니 그 16개는 한 번도 나오지 않았다. 싫어요는 추천 5종과 요구사항 매칭의 모든 단계에 걸리게 했고, 응답에 사용자의 싫어요 기록이 새어 나가지 않게 했다.

무료 AI API 한도에 걸려 기능이 멈추던 것을, 제공자를 갈아타고 쉬었다 다시 걸어 넘겼다

문제 상황

태그 추출과 자연어 해석, 임베딩을 모두 Gemini 무료 등급에 기대고 있었다. 운영 중에 한도 초과가 나면 자연어 해석이 통째로 실패했다. 임베딩 채우기도 한도 초과를 만나면 그 자리에서 포기해 한 번에 100개 남짓만 채우고 멈췄고, 100개를 한꺼번에 보내는 요청은 낱개용으로 잡아 둔 5초 제한 안에 끝나지 못해 따로 실패했다.

해결 방안

글을 다루는 작업은 같은 요청을 다시 보내도 한도가 풀리지 않으므로, 재시도 대신 제공자를 바꾸는 쪽을 골랐다. Groq 를 먼저 부르고 안 되면 Gemini 로 넘어가는 순서를 만들었다. 재시도는 한도 초과에 도움이 되지 않아 뺐고, 차단기는 스프링 프록시를 거쳐야 동작하므로 호출 오류는 프록시까지 올려 보내고 응답을 읽다 생긴 실패만 안에서 삼키게 했다. 임베딩은 유료 전환이나 제공자 교체를 미루고, 한도에 걸리면 60초 쉬었다가 같은 묶음을 최대 세 번까지 다시 보내게 했다. 묶음 요청에는 낱개와 분리한 60초 제한을 따로 줬다.

결과

운영 중인 Gemini 가 한도 초과를 내는 상황에서도 자연어 해석이 Groq 로 성공했고, 영어 입력에서 인원 3명, 예산 2000센트, 제외 태그 Horror 를 정확히 뽑았다. 임베딩 채우기는 한 번에 100개에서 멈추던 것이 무료 한도가 허락하는 만큼 이어지게 됐고, 묶음 요청 제한은 5초에서 60초로 늘렸다. 다만 하루 한도는 그대로라, 그 시점 카탈로그 7,557개 중 1,000개에만 임베딩이 있었다.

무료 서버를 세 번 옮기며 데이터와 배포를 이어 갔고, 마지막에는 ARM 서버로 바꿨다

문제 상황

운영비를 0원으로 유지하려고 무료 서버를 세 번 옮겼다. Lightsail 에서 DigitalOcean 학생 크레딧으로 갔고, 크레딧이 끝나자 오라클 클라우드 무료 등급으로 갔다. 마지막 이전에서는 옛 서버를 먼저 닫아 버려서 백업 없이 카탈로그와 기록을 잃었다. 새 서버는 x86 이 아니라 ARM 이라 기존 이미지가 아예 돌지 않는 문제도 있었다.

해결 방안

DigitalOcean 으로 옮길 때는 두 서버에 동시에 접속해 옛 서버에서 뽑아낸 덤프를 새 서버로 바로 흘려 넣어, 벡터 인덱스까지 그대로 복원했다. 오라클로 옮길 때는 복구할 데이터가 없어 스키마를 새로 만들고 크롤러로 카탈로그를 다시 채웠다. ARM 대응은 빌드 전체를 느린 에뮬레이션으로 돌리는 대신, 빌드는 작업 머신의 원래 아키텍처에서 하고 아키텍처를 타지 않는 jar 만 ARM 용 이미지에 얹는 방식을 골랐다. 다시 채우는 동안에는 상세 크롤러가 끝이 없는 순환 구조라는 것을 확인해 겹쳐 돌지 않게 잠금을 걸었고, 임베딩 러너가 상세 크롤러보다 훨씬 빨라 상세 정보도 없는 게임을 먼저 임베딩하며 무료 한도를 두 번 쓰는 것을 로그에서 찾아 하루 한 번으로 줄였다.

결과

DigitalOcean 으로 옮길 때는 게임 7,557개와 임베딩 1,000개를 그대로 살렸다. 오라클로 옮긴 뒤에는 SteamSpy 88페이지를 돌아 게임 32,339개를 다시 모았고, 이미지가 ARM 용으로 바뀐 것과 이전 뒤 상태 점검, 인증서 재발급까지 확인했다. 백업이 없어 노출과 피드백 기록을 잃은 것은 이 작업의 실패로 남겨 두었다. 그 뒤 2026-09-26부터 DB를 매일 백업하고 7일 동안 보관한다.

아쉬웠던 점

확장하면서 가장 어려웠던 것은 추천 품질이 아니라 추천 근거였습니다. 이유를 언어 모델에게 쓰게 하면 문장은 그럴듯하지만 실제로 건 조건과 어긋날 수 있습니다. 그래서 이유는 규칙으로 만들고 언어 모델은 입력을 조건으로 바꾸는 데까지만 쓰도록 경계를 그었습니다. 사용자에게 근거를 보여주기로 한 이상, 근거가 틀리면 추천이 틀린 것보다 나쁘다고 봤습니다. 남은 한계도 있습니다. 백업 정책 없이 서버를 옮기다 노출과 피드백 기록을 잃었고, 그 뒤에야 매일 백업을 걸었습니다. 임베딩은 무료 한도에 묶여 있어 분위기 매칭이 카탈로그의 일부에서만 온전합니다. 자연어 해석은 협동 여부를 모델이 비워 두는 경우가 있어, 그 항목만은 폼 입력에 기대고 있습니다. 측정 루프는 막 만들었습니다. 노출과 반응이 쌓이면 개인화를 넣기 전후와 추천 경로별 성능을 숫자로 비교하는 것이 다음 단계입니다.

프로젝트 유형

개인 프로젝트

기간

2025.05 - Present

사용 기술

16 Technologies