프로젝트 목록으로
팀 프로젝트2026.07 - Present

MSG CTF Instance Scheduler

대회 문제 서버의 생성, 상태 추적, 만료 후 정리를 맡는 Kotlin 백엔드입니다. 2026-11-08 제3회 MSG CTF에 투입됩니다.

내 역할

스케줄러 파트를 혼자 맡아 설계, 구현, 테스트, 개발 서버 배포를 담당했습니다. 브로커와 런타임은 다른 팀원이 만들었고, 대회 직전 연동 기간에는 다른 파트 팀원들이 연동 지점 일부를 함께 고쳤습니다.

결과

장애 주입 시험에서 찾은 정리 포기 결함을 고쳐, 런타임 150초 장애 뒤 남은 컨테이너를 100개에서 0개로 줄였습니다. 전체 테스트 655건(2026-10-26 기준)입니다.

담당 역할

MSG CTF 개발팀에서 스케줄러 파트를 1인으로 담당했습니다. 생성, 삭제, 연장, 초기화 API와 만료 자동 정리, 브로커와 런타임 연동, 팀별 생성 한도, 상태 이벤트 기록을 설계하고 구현했습니다. 실사용 전이라 부하와 장애는 실제 브로커와 런타임, 그리고 이를 흉내 낸 가짜 서비스로 재현해 확인했습니다. 대회 직전 연동 기간에는 다른 파트 팀원들이 Gateway 연동과 기동 자원 설정 등 연동 지점 일부를 함께 고쳤습니다.

Tech Stack

KotlinSpring BootJPAPostgreSQLFlywayTestcontainersGitHub ActionsGCP

아키텍처 / ERD

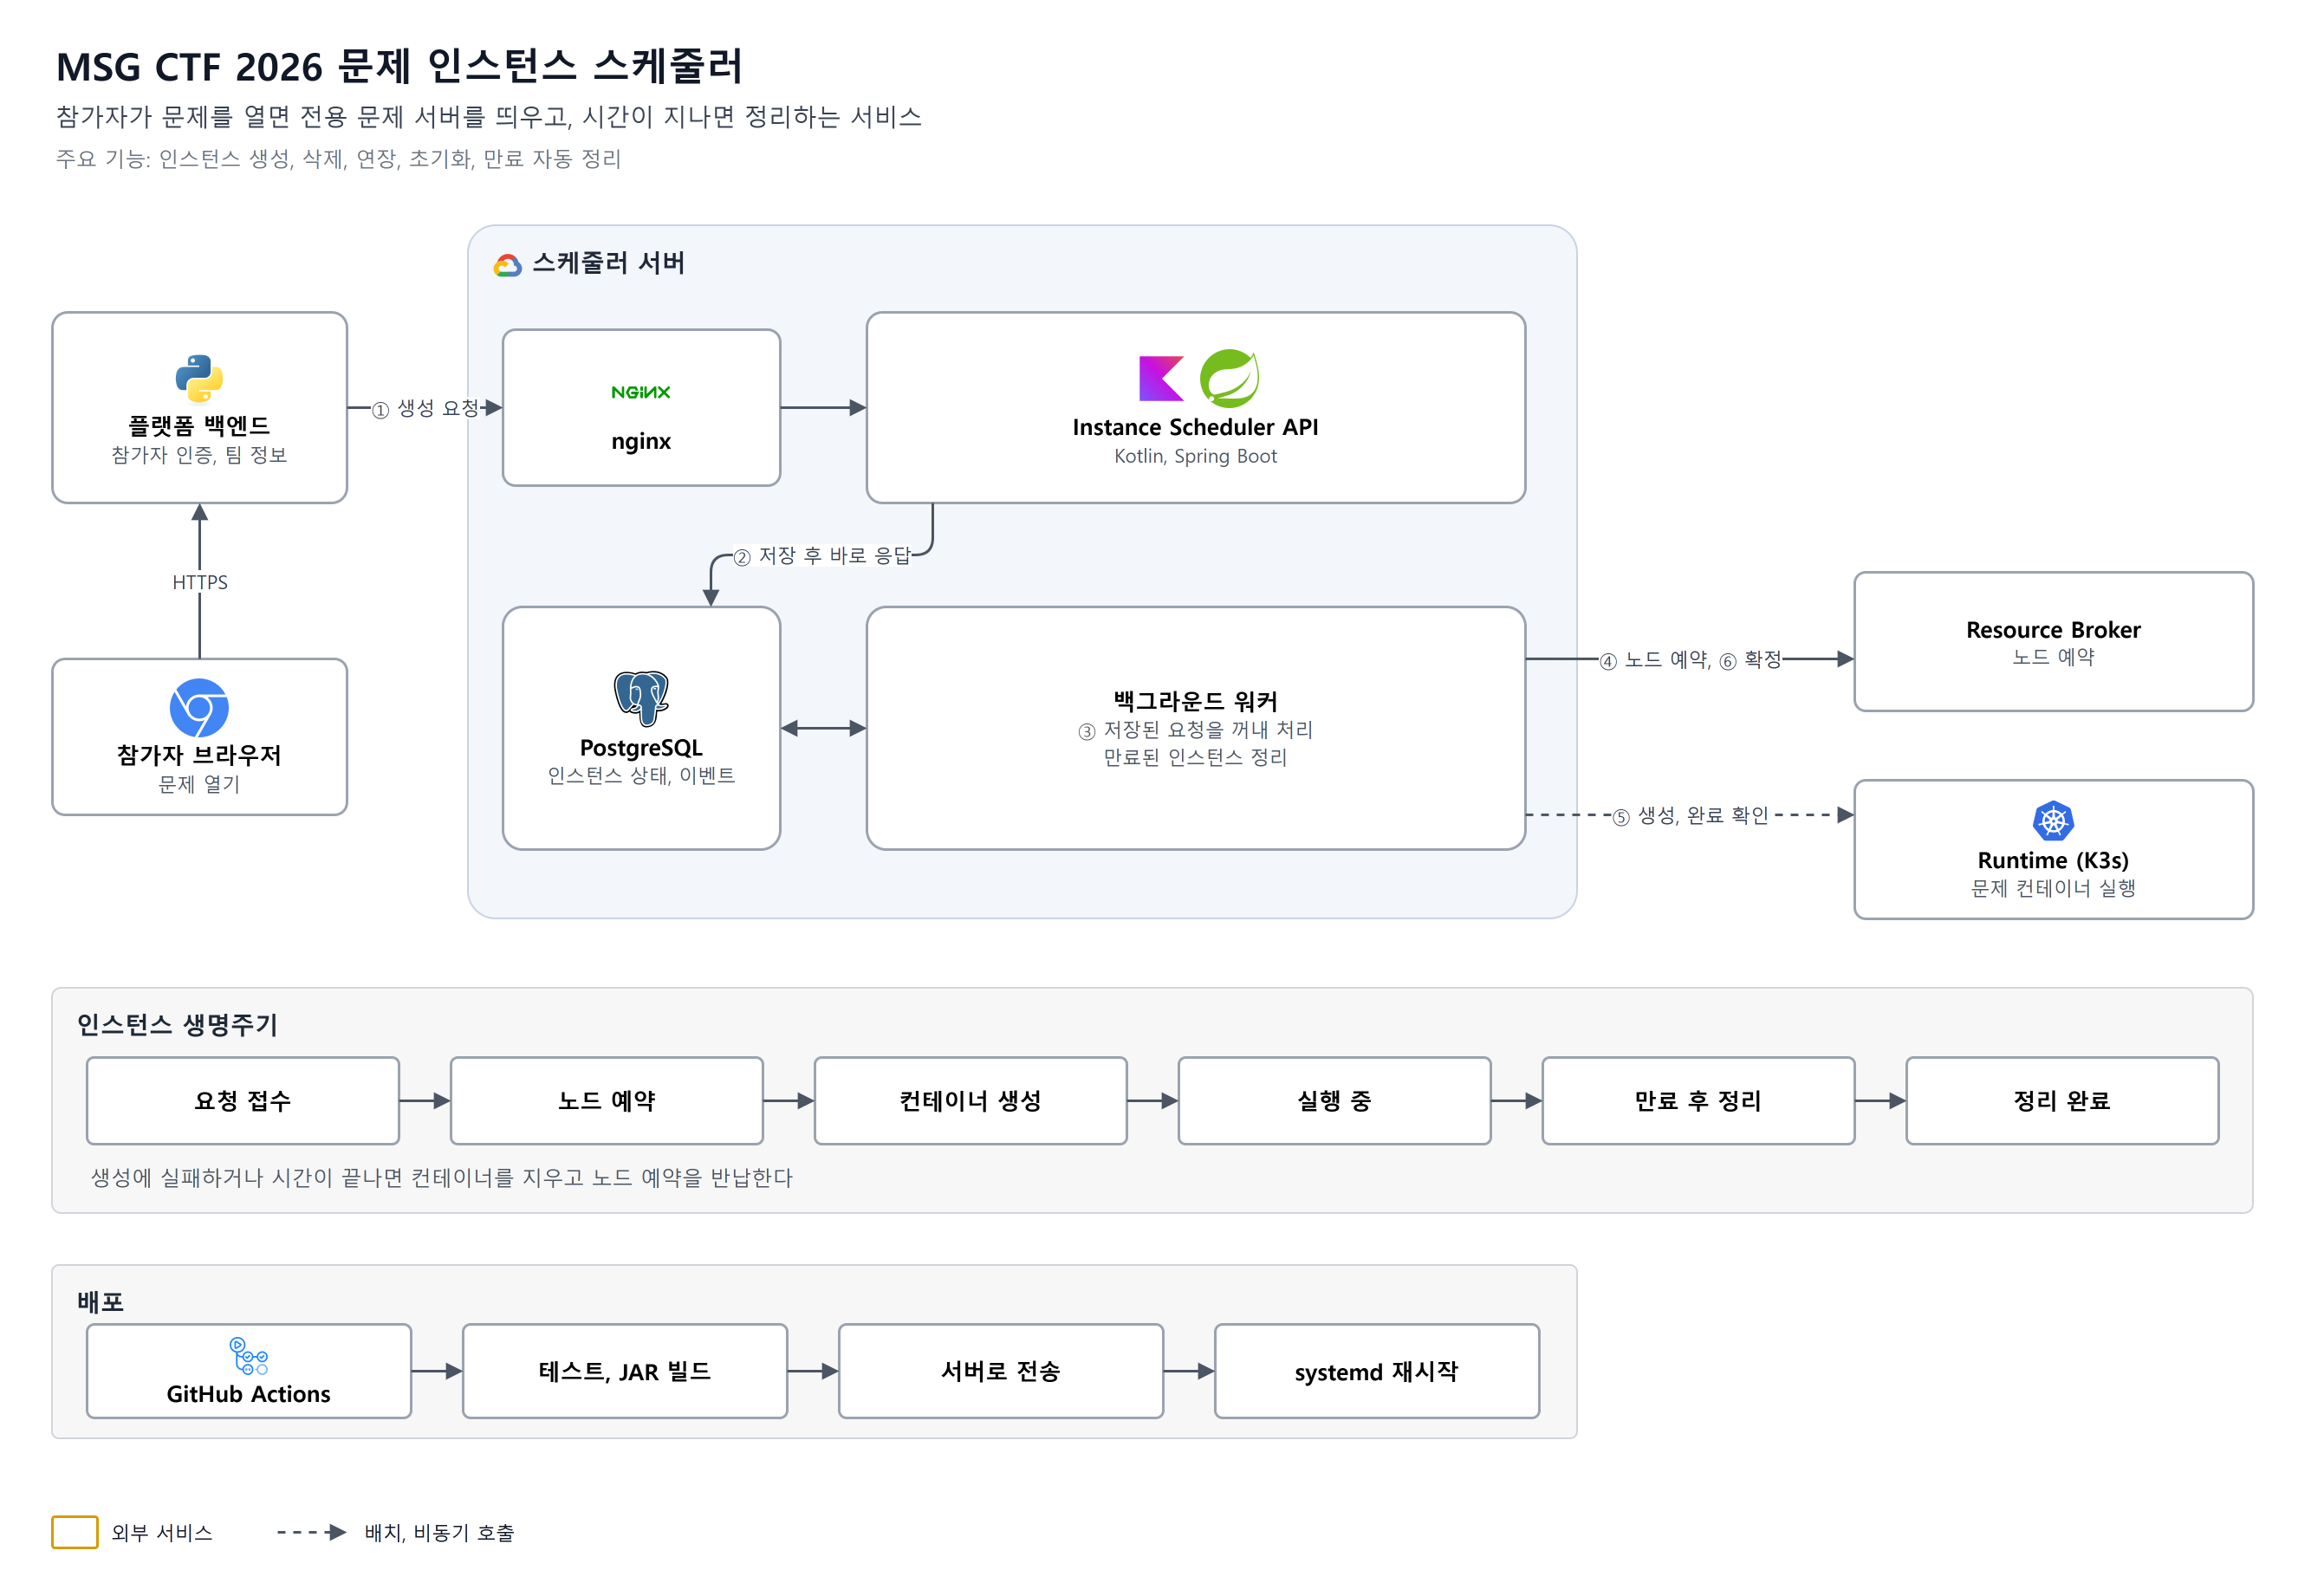
전체 구조와 인스턴스 생명주기

API는 요청을 저장하고 바로 응답하며, 백그라운드 워커가 브로커 예약과 런타임 생성, 만료 후 정리를 이어서 처리합니다.

MSG CTF Instance Scheduler 전체 구조와 인스턴스 생명주기

문제 해결 과정

장애 주입 시험으로, 런타임이 잠시 멈추면 정리를 포기하고 자리가 이중 배정되는 결함을 찾아 고쳤다

  • 장애 뒤 남은 컨테이너 100 → 0개
  • 돌연변이 12/12 검출

문제 상황

앞선 부하 시험은 모든 요청이 성공하는 경우만 봤다. 대회 중 런타임이 잠시 응답하지 못할 때 문제 서버와 자원 예약이 새는지는 아무도 확인하지 않았다. 가짜 런타임에 장애를 주입해 보니, 삭제 접수가 5번 연속 실패하면(약 100초) 인스턴스를 FAILED로 옮기고 예약을 반납하는 경로가 있었다. FAILED는 워커가 다시 보지 않아 컨테이너가 남는데, 브로커는 그 자리를 비었다고 보고 다른 팀에 다시 배정한다.

해결 방안

재시도 한도를 포기하는 기준이 아니라 경보 기준으로만 쓰기로 했다. 런타임이 지워졌다고 확인해 줄 때만 정리를 끝내고, 그 밖의 실패는 상태와 예약을 쥔 채 재시도한다. 장애가 길어지면 새 요청을 받을 자리가 줄지만, 사용 중인 자리를 다시 배정하는 것보다 낫다고 봤다. 같은 정리 경로를 다른 설계로 고친 팀원의 초안(확정 실패는 운영자에게 넘기기)과 충돌했다. 런타임 소스를 읽어 같은 요청 id의 재접수는 다시 실행되지 않는다는 것을 확인하고, 런타임이 확정한 실패는 운영자 재시도로, 일시적인 실패는 자동 재시도로 나눠 두 설계를 합쳤다.

결과

로컬에서 가짜 브로커와 런타임으로 100건을 만든 뒤 런타임 전체 장애를 150초 걸었다. 고치기 전에는 약 40초 만에 100건이 FAILED가 되고 컨테이너 100개가 남았다. 고친 뒤에는 장애 내내 삭제 진행 중으로 남았다가, 복구 뒤 40초 안에 100건이 모두 정리되고 남은 컨테이너와 예약이 0이 됐다. 같은 틀로 강제 재시작과 만료 몰림(각 300건), 약 1시간 49분 동안 1,520건을 도는 장시간 시험도 돌려 남은 컨테이너 0을 확인했다. 전체 테스트 655건이 통과했고, 판정 로직을 일부러 바꾼 코드 12개를 모두 테스트가 잡았다.

동시 요청이 한 노드로 몰려 자리가 있는데도 실패하던 문제를, 해시 기반 후보 순서로 풀었다

  • FAILED 47 → 0건
  • 409 248 → 13회

문제 상황

브로커 노드 하나에는 인스턴스가 평균 3개 들어간다. 스케줄러가 매번 같은 후보를 골라 동시에 처리하는 요청이 모두 한 노드로 갔고, 늦은 쪽이 받는 자리 부족(409)이 재시도 3회 한도를 써서 실패했다. 기존 부하 측정은 가짜 브로커의 용량이 무제한이라 이 경합이 드러나지 않았다.

해결 방안

후보 순서를 인스턴스마다 다르게 두되, 무작위가 아니라 인스턴스 id와 후보 id의 해시로 정했다. 예약 응답을 잃고 재시도할 때 같은 후보로 가야 브로커가 이미 잡아 둔 예약을 돌려주기 때문이다. 자리 부족 409는 같은 주기에 다음 후보로 넘어가고 재시도 횟수를 쓰지 않게 했다. 팀 리뷰에서 마지막 자리를 잡은 예약의 응답을 잃으면 다음 후보 조회가 비어 실패하는 경로가 재현됐다. 응답을 못 받은 예약 요청을 저장해 두고, 다음 주기에 같은 요청을 다시 보내 브로커가 돌려주는 예약을 되찾게 했다.

결과

후보 70개, 노드당 3자리, 병렬 8, 200건 동시 생성에서 FAILED가 47건(23.5%)에서 0건으로, 409가 248회에서 13회로 줄었다. 두 리뷰어가 재현한 상황은 실제 PostgreSQL 통합 테스트로 고정했다.

근거

동시 요청이 팀별 생성 한도를 넘는 문제를, 팀 단위 잠금으로 막았다

문제 상황

팀별 생성 한도를 검사하는 코드가 있어도, 두 요청이 동시에 들어오면 제한을 넘길 수 있었다. 이미 1개를 쓰는 팀에서 두 요청이 각각 사용량을 1개로 읽으면 한도인 2개를 넘어 3개째가 만들어진다. 대회 전 설계 검토에서 발견해 테스트로 재현했다.

해결 방안

READ COMMITTED에서는 서로 커밋하지 않은 데이터를 보지 못하고, 새 인스턴스는 아직 저장되지 않아 잠글 대상이 없다. 그래서 이미 쓰고 있는 PostgreSQL의 트랜잭션 범위 advisory lock을 팀 id 해시로 잡고 사용량 확인과 저장을 순서대로 처리했다. 별도 잠금 인프라가 필요 없고 트랜잭션이 끝나면 자동으로 풀린다. 해시가 충돌하면 다른 팀도 잠깐 기다릴 수 있다는 제약은 받아들였다.

결과

Testcontainers로 띄운 PostgreSQL에서 한 자리만 남긴 팀에 두 요청을 동시에 보내면, 하나만 성공하고 다른 하나는 한도 초과(409)로 거절되는 것을 확인했다.

부하 시험으로 대회 규모의 병목이 스케줄러가 아니라 런타임 삭제라는 것을 확인했다

  • 스케줄러 CPU 최대 3%
  • 500건 실패 0, 접수 p99 482ms

문제 상황

대회(예상 최대 동시 인스턴스 약 300개)를 앞두고 인스턴스 생성 경로가 버티는지 아무도 재지 않았다.

해결 방안

실행 문서를 먼저 쓰고 측정 도구를 실서버용으로 넓혔다. 실제 브로커와 런타임으로 1건, 6개씩 4번, 남은 자리보다 많은 20건을 보냈다. 클러스터가 작아 실제 300개는 만들 수 없어서, 같은 코드에 가짜 브로커와 런타임을 붙여 500건을 따로 돌렸다. 숫자는 도구 집계가 아니라 DB 이벤트 기록으로 쟀다.

결과

실제 환경 24건은 모두 정상이었고 스케줄러 CPU는 최대 3%였다. 반면 런타임 삭제는 2개씩 약 60초라, 300개를 정리하려면 약 150분이 걸리고 그동안 자리가 반납되지 않는다. 스케줄러만 단독으로 돌린 500건은 실패 0, 생성 접수 p99 482ms였다. 그래서 대회 전에 먼저 확인할 대상을 노드 수보다 런타임의 동시 삭제 개수로 정리했다.

프로젝트 유형

팀 프로젝트

기간

2026.07 - Present

완료

2026.11

사용 기술

8 Technologies